
Comparer uniquement ce qui est comparable
Même contenance, même puissance, même teinte, même senteur, même positionnement : vos écarts de prix reposent sur de vraies équivalences.
Un logiciel de matching produit rapproche automatiquement chacun de vos produits de son équivalent chez vos concurrents, jusqu'à la variante, pour des comparaisons de prix justes.
BOOPER propose les correspondances par code EAN, NLP sur les libellés, reconnaissance d'image et attributs, avec un score de confiance. Vos équipes valident les cas douteux, l'algorithme apprend. Le clonage relie vos produits au marché, le chaînage les relie entre eux.
Données de démonstration
Ils pilotent leurs prix avec BOOPER
Rapprochez sans ressaisie.Distinguez chaque variante.Comparez vos prix aux bons produits.
Le matching, le clonage et le chaînage de vos produits avec ceux du marché.
Pricing, category management, études et achats, qui comparent leurs prix à la concurrence.
Un écart de prix n'a de sens que si les deux produits sont réellement comparables.
EAN, NLP sur les libellés, attributs et reconnaissance d'image, puis validation humaine.
Sur les points de vente, sites web, marketplaces et catalogues de distributeurs concurrents.
En continu, à chaque changement d'assortiment ou de positionnement chez un concurrent.
Une compréhension du libellé et de l'image, pas une simple correspondance de texte ni des règles rigides.
Quand le code EAN est partagé, le rapprochement est immédiat.
Sans EAN, l'IA lit les libellés, les attributs, les formats et les marques, et analyse la photo du produit pour proposer l'équivalent le plus proche.
Chaque proposition porte un taux de matching et un score de confiance. Vos validations font apprendre l'algorithme.
Vos produits sont reliés entre eux (hiérarchie, coefficients, historique) selon vos propres règles.
Même code EAN, rapprochement immédiat
Sans EAN commun, le libellé et la photo sont analysés ensemble
Vos équipes n'arbitrent que les cas douteux
Vos propres produits reliés entre eux, selon vos règles
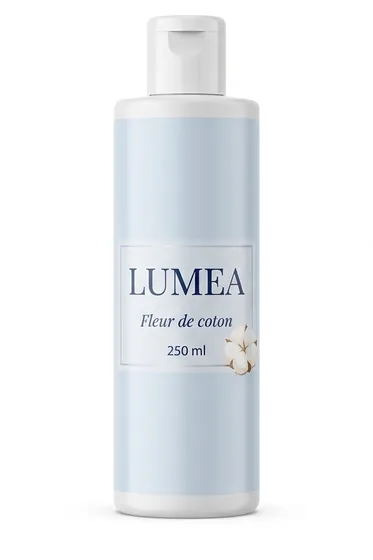 Gel douche Lumea fleur de coton 250 mlRéf. interne GD-LUM-250-CO
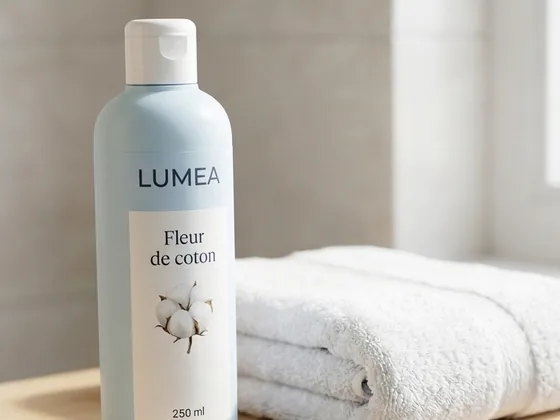 Lumea gel dche fl. coton 250mlRéf. vendeur LUM-FC250
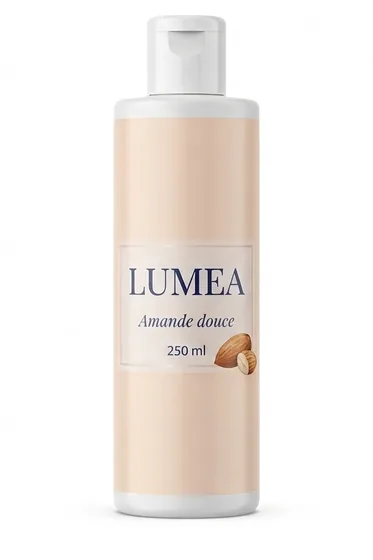 Lumea gel douche amande douce 250 mlMême marque, même flacon, même contenance : senteur différente, l'offre n'est pas rattachée à votre référence.Variante écartée
Données de démonstration, marque fictive
Dans une même gamme, deux produits ne diffèrent parfois que par une senteur, une teinte ou une contenance. BOOPER lit le libellé et regarde la photo : chaque offre concurrente est rattachée à la bonne variante, automatiquement.
Le matching est la base de toute analyse de la concurrence : un rapprochement juste rend chaque écart de prix exploitable.
Même contenance, même puissance, même teinte, même senteur, même positionnement : vos écarts de prix reposent sur de vraies équivalences.
Une base commune, structurée et gouvernée, qui alimente ensuite tous vos autres modules de pricing.
L'IA propose, vos équipes arbitrent seulement les cas douteux signalés par un score de confiance faible.
Changements d'assortiment ou de positionnement chez un concurrent : ils sont détectés dès qu'ils surviennent.
Le clonage relie vos produits à ceux des concurrents. Le chaînage relie vos produits entre eux, en chaînage vertical comme en chaînage horizontal.
| Critère | Clonage | Chaînage |
|---|---|---|
| Relie | Un produit de votre assortiment et son équivalent concurrent | Des produits de votre propre assortiment |
| Quand | Quand il n'y a pas d'association directe par EAN | Pour structurer gammes et variantes |
| Concerne | Marque propre comme marque nationale | Chaînes MN / MDD / premiers prix, vertical et horizontal |
| Sert à | Comparer vos prix au marché | Tenir des rangs de prix cohérents, analyser cannibalisation et montée en gamme |
Le rapprochement à la main fonctionne sur un échantillon. Le matching par IA tient la même rigueur sur des milliers de références, avec moins de temps passé. Industrialiser la veille concurrentielle à grande échelle.
Chaque validation rend les propositions suivantes plus justes. Plus votre référentiel est riche (libellés, attributs, historiques de prix), plus le rapprochement est précis. Fiabiliser sa donnée avant un outil de pricing.
Partout où vos concurrents décrivent le même produit avec d'autres mots, d'autres codes ou d'autres formats.
Comparer magasins, drives et sites e-commerce concurrents, et structurer vos chaînes de gammes.
Pricing beauté et santé →Rapprocher des catalogues de distributeurs aux libellés et codes fabricants hétérogènes, attribut par attribut.
Pricing retail BtoB →Suivre les mêmes références chez les pharmacies en ligne, parapharmacies et grandes surfaces.
Pricing en officine →Quelle part de votre catalogue est vraiment comparée à la concurrence aujourd'hui ?
Mesurons votre taux de matching sur un échantillon de vos références.
Des prix concurrents qui servent à décider, pas à archiver.
Les prix concurrents arrivent directement dans l'outil, rapprochés des articles de l'enseigne par clonage et chaînage des références. Les indices sont à jour, et chaque alignement est simulé avant d'être validé par l'équipe.
de disponibilité de la plateforme en 2025, en production depuis 2022.
Un prix par groupe de magasins, revu toutes les six semaines.
Le groupe gérait plusieurs enseignes sous Excel, avec des procédés manuels. Désormais, les tarifs sont chaînés, simulés par lots et déclinés par groupe de magasins. Chaque cycle de prix part d'une base propre.
par cycle de prix, simulé par lots sur l'ensemble des enseignes.
À lire : les limites d'Excel pour le pricing
Des prix cohérents sur tout le réseau, sans perdre la main.
L'enjeu n'était pas d'avoir un outil de plus. Il fallait tenir une cohérence tarifaire nationale sur des millions de prix, simuler chaque scénario par catégorie, et laisser la décision finale aux équipes métier.
points de vente couverts par une même gouvernance prix centralisée.
À lire : la plateforme de pricing modulaire
Pas le prix le plus bas : le bon prix, et un point de marge en plus.
Le groupe appliquait un seul taux de marge à tout le magasin. Désormais, chaque catégorie a son rôle : trafic, chiffre d'affaires ou marge. Les remarques sur des prix trop chers ont disparu et les concurrents relèvent les prix.
de taux de marge sur les produits testés, en un trimestre.
À lire : comment mesurer son image prix
Savoir enfin quelles références portent vraiment la marge.
En classant l'assortiment, l'équipe a vu qu'un petit nombre de références faisait l'essentiel des ventes et de la marge. Avant de retirer un produit, elle teste d'abord une baisse de prix et observe la réaction des ventes.
de trésorerie visés, de 20 000 à 12 000 références (objectif en cours).
À lire : le pricing en jardinerie
Chaque changement de prix est mesuré contre un groupe témoin.
Les nouveaux prix ont d'abord été déployés sur quelques magasins pilotes, comparés à des magasins témoins. Les résultats sont lus chaque semaine, puis complétés par une enquête de perception prix en magasin.
clients interrogés en magasin pour mesurer la perception prix du pilote.
À lire : simuler sa stratégie prix
Un diagnostic qui montre où se joue vraiment la marge.
L'enseigne pensait connaître son positionnement. Le diagnostic a comparé ses prix au marché, pondérés par ses volumes, et a montré l'écart de marge entre les produits exposés à la concurrence et les autres.
des produits font 80 % des ventes de tout le réseau.
À lire : le diagnostic prix
Des scénarios de prix enregistrés, comparés et rejouables.
La stratégie du magasin : être le moins cher de la zone. Booper sert de base d'alignement face aux concurrents, et chaque scénario est enregistré : ce qui a été décidé, pourquoi, et la possibilité de le rejouer.
utilisateurs suffisent à piloter l'alignement prix de l'hypermarché.
À lire : simuler l'impact d'un prix
Retours d'expérience rédigés par Booper à partir de projets clients réels. Les clients sont anonymisés. Retrouvez nos références sur la page qui sont nos clients.
Vous ne trouvez pas votre réponse ? Posez-la directement à notre équipe. Pour la définition seule, voir la fiche matching produit du glossaire.
Toutes les questions sur le pricing →L'association de produit, ou matching dans certaines situations, consiste à identifier automatiquement des produits équivalents entre différentes enseignes ou gammes afin de comparer leurs prix, performances et positionnements concurrentiels sur une base homogène.
Ce travail répond à un problème simple mais structurant : comparer des prix n'a de sens que si l'on compare des produits réellement équivalents. Sans association fiable, une veille concurrentielle risque de comparer des références proches mais différentes (un format distinct, une composition légèrement différente) et de fausser les conclusions sur le positionnement prix réel de l'enseigne.
BOOPER MPS structure cette association à travers plusieurs mécanismes complémentaires : le matching automatique par IA pour les cas où les correspondances sont détectables via les libellés et attributs, le clonage lorsqu'il n'existe pas de correspondance directe par EAN, et le chaînage pour organiser les relations entre les produits de l'enseigne elle-même.
Pour un retailer, cette association de produit est un prérequis souvent invisible mais indispensable à toute stratégie de pricing concurrentiel sérieuse : elle conditionne la fiabilité de la veille tarifaire et, en cascade, la pertinence des décisions de prix prises en réaction ou en anticipation du marché.
L'IA analyse simultanément les libellés, attributs, formats, marques et comportements prix pour détecter des similarités invisibles à l'analyse humaine. Elle apprend continuellement à partir des validations utilisateurs pour améliorer sa précision. Lorsqu'elle est disponible, l'IA prend également en compte la reconnaissance d'image.
Le principal apport de l'IA sur ce sujet est la capacité à traiter des libellés produits hétérogènes : deux enseignes différentes nomment rarement une même référence de la même façon, ce qui rend impossible un rapprochement fiable par simple correspondance de texte. Le traitement du langage naturel permet de reconnaître qu'il s'agit du même produit malgré des intitulés différents, en s'appuyant sur les attributs, le format et la marque en complément du libellé.
Cette précision s'améliore dans le temps grâce à un mécanisme d'apprentissage continu : chaque validation ou correction apportée par un utilisateur enrichit le modèle, qui affine progressivement ses recommandations sur les rapprochements futurs plutôt que de rester figé sur ses réglages initiaux.
Pour un retailer, cette capacité change l'échelle à laquelle un travail de matching peut être mené : un traitement manuel de rapprochement produit atteint vite ses limites sur un assortiment de plusieurs milliers de références suivies sur plusieurs enseignes concurrentes, là où l'IA permet de couvrir ce volume tout en conservant une validation humaine sur les cas incertains.
Un matching manuel rapproche les produits un par un, en comparant les libellés et les fiches, souvent dans un tableur ; un matching basé sur l'IA propose automatiquement les correspondances. Chez BOOPER, le code EAN rapproche immédiatement les produits qui le partagent ; sans EAN commun, l'IA lit les libellés par traitement du langage (NLP), compare les attributs, les formats et la marque, et analyse la photo du produit. Chaque proposition porte un score de confiance.
La différence tient d'abord au volume et à la précision. À la main, couvrir plusieurs milliers de références suivies sur plusieurs enseignes concurrentes, et les tenir à jour à chaque changement d'assortiment, demande un temps considérable. L'IA traite ce volume et distingue des variantes très proches d'une même gamme : contenance, teinte, senteur.
Le matching par IA ne supprime pas la validation humaine : il la concentre sur les rapprochements incertains, signalés par un score de confiance faible, et chaque validation fait apprendre l'algorithme. Pour approfondir, voir notre guide du matching produit concurrentiel.
Lorsqu'il n'y a pas d'association directe par EAN, le clonage prend le relais et lie les produits de l'enseigne avec ceux de la concurrence ; cela concerne tout aussi bien la marque propre que la marque nationale. L'autre type de relation complémentaire est le chaînage : les produits de l'enseigne sont regroupés pour établir des liens de hiérarchie, de coefficients et de modèle d'historique.
Ces deux mécanismes répondent à des besoins différents. Le clonage sert la comparaison concurrentielle : il permet de rapprocher un produit de l'enseigne d'un équivalent chez un concurrent lorsque le rapprochement automatique par identifiant standard (EAN) n'est pas possible, par exemple pour une marque propre qui n'a pas d'équivalent direct référencé chez le concurrent.
Le chaînage, lui, travaille en interne sur l'assortiment de l'enseigne : il structure des liens hiérarchiques entre références proches (déclinaisons de formats, de conditionnements) et des coefficients qui permettent de reconstituer un historique cohérent même lorsque des références évoluent ou sont remplacées dans le temps.
Pour un retailer, ces deux relations sont complémentaires plutôt que redondantes : le clonage sécurise la lecture concurrentielle externe, tandis que le chaînage sécurise la continuité et la cohérence de l'analyse interne, notamment lorsqu'un produit change de référence sans changer réellement de nature.
Oui : BOOPER identifie les produits substituables selon leurs attributs fonctionnels et leur positionnement prix, ce qui permet de structurer vos chaînes de produits (marque nationale, MDD, premier prix) et vos gammes. Les liens retenus (hiérarchie, coefficients, historique) suivent vos propres règles.
Le chaînage relie les produits de votre propre assortiment, là où le clonage les relie à ceux des concurrents. Il sert à tenir des rangs de prix cohérents dans une gamme et à analyser la cannibalisation et la montée en gamme entre marque nationale, MDD et premier prix.
Comme pour le matching, la proposition reste soumise à vos équipes : vos règles de gestion décident des chaînes appliquées. Pour le principe, voir la définition du chaînage automatique.
BOOPER identifie les produits substituables selon leurs attributs fonctionnels et leur positionnement prix afin de structurer des chaînes MN/MDD/PPx et d'analyser les effets de cannibalisation et de montée en gamme.
Cette structuration répond à un enjeu central du category management : marque nationale, marque de distributeur et premier prix ne sont pas des univers isolés mais des références qui interagissent entre elles dans les arbitrages d'achat des clients. Chaîner ces produits entre eux permet d'analyser comment une évolution de prix sur l'un affecte les ventes des autres, plutôt que d'analyser chaque référence de façon isolée.
Concrètement, cette analyse met en évidence des effets de cannibalisation (un client qui bascule d'une marque nationale vers une MDD lorsque l'écart de prix se resserre trop) ou des effets de montée en gamme, lorsque la différence de qualité perçue justifie un écart de prix plus large sans perte de volume.
Pour un retailer, cette lecture croisée MN/MDD/PPx est déterminante pour construire une architecture de prix cohérente sur une catégorie : fixer le prix d'une MDD sans tenir compte de son positionnement par rapport à la marque nationale équivalente revient à ignorer une grande partie de la dynamique réelle de la demande sur le rayon.
Non, l'association n'est pas entièrement automatisée. Bien que les recommandations deviennent de plus en plus intelligentes et automatiques, l'association nécessite une validation par un humain de manière à faire apprendre les algorithmes.
Ce choix n'est pas une limite technique mais un principe méthodologique : une association produit erronée fausse ensuite toutes les analyses concurrentielles qui s'appuient dessus, avec un effet en cascade sur les décisions de prix. Conserver un contrôle humain sur les cas incertains permet d'éviter que des erreurs de rapprochement se propagent silencieusement dans le pilotage pricing.
Ce fonctionnement s'inscrit dans une logique d'apprentissage continu : plus les utilisateurs valident ou corrigent les propositions de l'IA, plus le modèle affine sa précision et réduit, avec le temps, la part des cas nécessitant une intervention manuelle. L'automatisation progresse donc, mais reste toujours doublée d'un contrôle métier sur les rapprochements les moins évidents.
Pour un retailer, cet équilibre entre automatisation et validation humaine est un gage de fiabilité : il évite de sacrifier la qualité du référentiel produit à la vitesse de traitement, alors que ce référentiel conditionne directement la justesse des décisions de prix qui s'appuient sur les comparaisons concurrentielles.
MPS exploite les référentiels produits, les libellés, les attributs techniques, les historiques prix et les données concurrentielles. Plus la donnée est riche, plus la proposition d'association est précise.
Le référentiel produit et les libellés constituent la base du rapprochement : plus les attributs disponibles sont complets et structurés (format, marque, conditionnement, catégorie), plus l'IA dispose d'éléments fiables pour distinguer des produits réellement équivalents de produits seulement proches. Les historiques prix et les données concurrentielles viennent ensuite affiner et valider ces rapprochements dans la durée.
Lorsque les référentiels produits sont incomplets ou peu structurés (libellés génériques, attributs manquants), la précision des propositions d'association en pâtit directement, ce qui explique pourquoi la validation humaine reste nécessaire sur les cas où la donnée source manque de qualité.
Pour un retailer, cela signifie que la qualité du matching produit dépend en partie d'un travail de fond souvent négligé : la structuration et la fiabilisation du référentiel produit interne, qui conditionne la performance de tous les modules qui s'appuient dessus ensuite, du matching à l'analyse concurrentielle.
Les gains proviennent de la réduction du temps manuel, de la fiabilité des comparaisons prix, de l'amélioration des décisions commerciales et de la performance concurrentielle globale. Les premiers bénéfices sont généralement observés en quelques mois.
Le temps manuel économisé est souvent le premier effet visible : le rapprochement produit entre enseignes concurrentes est un travail traditionnellement chronophage lorsqu'il est fait à la main, référence par référence, et particulièrement difficile à maintenir à jour sur un assortiment large avec un fort taux de renouvellement de produits.
Le gain de fiabilité, lui, se mesure moins directement mais pèse davantage sur le long terme : des comparaisons concurrentielles construites sur un référentiel produit fiable évitent des décisions de prix biaisées par de mauvais rapprochements, ce qui améliore la qualité des arbitrages tarifaires dans la durée plutôt que sur une seule campagne.
Pour un retailer, ce module constitue souvent une brique de fond peu visible mais structurante : il ne génère pas directement de la marge par lui-même, mais il conditionne la fiabilité de toutes les analyses concurrentielles et décisions pricing qui s'appuient ensuite sur ces comparaisons produit.
Le matching produit alimente la solution de pricing BOOPER MPS : chaque prix concurrent est rapproché du bon produit avant toute recommandation.
Nos guides pour fiabiliser vos comparaisons concurrentielles, votre référentiel produit et vos architectures de gammes.
Un référentiel fiable, jusqu'à la variante, qui sécurise toutes vos analyses concurrentielles.
30 grands comptes actifs en France, Pologne, Vietnam et Thaïlande