
IA généraliste vs solution de pricing spécialisée : pourquoi ce n'est pas un choix

Un LLM généraliste part sans quatre briques qu'exige une décision de prix : la donnée réelle connectée, les règles métier, la simulation d'impact et une trace auditable. Il oublie aussi le contexte d'une session à l'autre, alors que le pricing est un métier de contexte accumulé.
Selon l'étude MIT NANDA 2025, les outils déployés avec un éditeur spécialisé atteignent la production environ deux fois plus souvent que ceux construits en interne. La bonne répartition laisse au LLM l'exploration et la rédaction, et à la solution spécialisée le prix final.
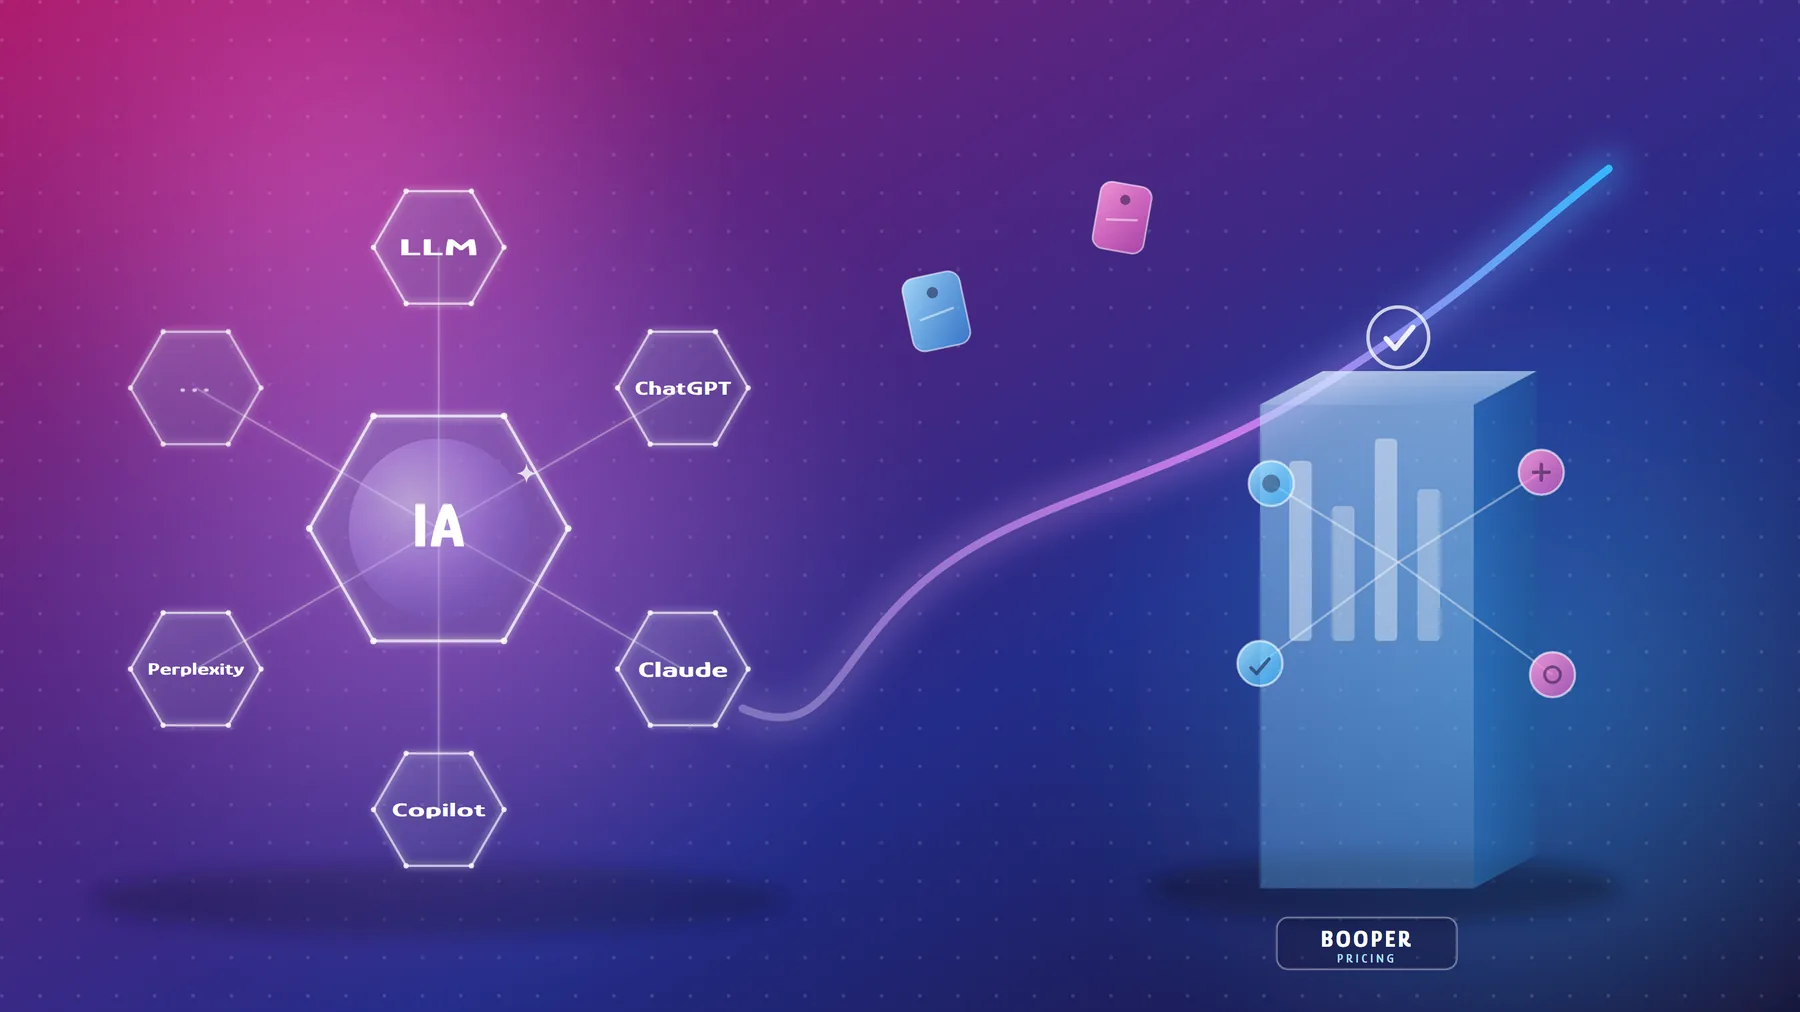
Un LLM généraliste, comme ChatGPT, Claude ou Copilot, sait formuler, résumer et explorer. Une solution de pricing spécialisée sait chiffrer, simuler et justifier un prix. Ce ne sont pas deux candidats au même poste.
La question utile n'est donc pas de choisir l'un contre l'autre, mais de décider ce que chacun porte dans la décision de prix. Notre position : le LLM formule, la solution chiffre, l'équipe signe.
Un dilemme mal posé
La question revient dans beaucoup de comités : « nos équipes utilisent déjà un LLM, pourquoi ne pas lui demander nos prix ? » Elle est légitime. Elle confond pourtant deux métiers.
Un modèle de langage généraliste est entraîné à produire la suite de texte la plus plausible. Une solution de pricing est construite pour estimer l'effet d'un prix sur des ventes réelles, sous des règles explicites.
Notre dossier sur les erreurs de l'IA générative sur les prix détaille ce mécanisme : un LLM ne vérifie rien, il prédit. Cela ne le rend pas inutile, mais cela l'écarte de la décision finale.
Ce qui manque structurellement à un LLM généraliste
Quel que soit le modèle ou le prompt, un LLM généraliste part sans quatre briques qu'exige une décision de prix retail.
La donnée réelle. Sans branchement à un référentiel produit et à des prix concurrents à jour, il répond depuis sa mémoire d'entraînement, pas depuis la réalité du magasin.
Les règles métier. Marge plancher, cohérence de gamme, produits repères : il ne les connaît que si on les lui redit, sans garantie qu'il les respecte.
La simulation. Il ne teste pas l'effet d'un prix sur les ventes ou les stocks avant de le proposer. Il formule un texte, il ne simule rien.
La trace. Une décision de prix doit rester justifiable après coup. Un LLM produit un raisonnement plausible, rarement un audit exploitable.
Le cinquième manque : la mémoire du contexte
L'étude MIT NANDA rapporte la remarque d'un utilisateur : l'outil généraliste « répète les mêmes erreurs et exige qu'on lui redonne tout le contexte à chaque session ».
Pour un prix, ce contexte est considérable : le produit repère qu'on ne touche pas, l'écart contractuel avec la marque de distributeur, la catégorie en conquête ce trimestre.
Dans une solution spécialisée, ce contexte métier s'inscrit une fois dans des règles et des paramètres, puis s'applique à chaque recommandation. C'est toute la différence.
Le vrai risque : une justification plausible pour un prix jamais simulé
On redoute qu'un LLM donne un prix faux. Le risque le plus coûteux est plus subtil : qu'il donne une justification convaincante à un prix que personne n'a simulé.
Une note bien rédigée rassure un comité. Elle ne dit rien de l'effet sur les volumes, la marge ou les stocks. Plus le texte est fluide, plus on oublie que le chiffre n'a été testé nulle part.
D'où une règle que nous défendons : aucun prix ne part en magasin sur la seule foi d'un texte généré, même juste en apparence.
Le constat vaut au-delà du pricing. Selon Gartner, 30 % des projets d'IA générative devaient être abandonnés après la preuve de concept d'ici fin 2025, faute de donnée fiable, de coûts maîtrisés ou de valeur métier claire (juillet 2024).
L'étude MIT NANDA observe que 95 % des organisations étudiées ne tirent aucun retour mesurable de leurs projets d'IA générative. Ses auteurs l'attribuent moins aux modèles qu'à des outils qui n'apprennent pas et s'intègrent mal au travail réel.
Pourquoi combiner change la donne
Le même rapport compare les modes de déploiement. Le résultat est net, et il mérite d'être lu avec ses limites.
des outils déployés en partenariat avec un éditeur spécialisé ont atteint la mise en production, contre environ 33 % des outils construits entièrement en interne.
(MIT NANDA, The GenAI Divide: State of AI in Business 2025, juillet 2025, 52 organisations, résultats déclaratifs)
Les auteurs précisent que ces chiffres sont déclaratifs. Ils notent aussi que le cas hybride, une équipe interne qui codéveloppe avec un éditeur, manquait de données pour être chiffré.
Notre lecture : c'est précisément ce cas hybride qui fonctionne en pricing. L'équipe garde ses outils généralistes pour explorer et rédiger, la solution spécialisée porte la donnée, les règles, la simulation et la trace.
Simon-Kucher pointe le même manque : parmi les entreprises qui n'utilisent pas encore l'IA dans leur pricing, 54 % citent d'abord le manque d'expertise ou de ressources internes (Global Pricing Study 2025, plus de 2 200 dirigeants).
Ce que montre le terrain : une petite équipe, sans étape intermédiaire
Le Groupe Barbotteau, plus de 70 entreprises et enseignes dans la Caraïbe française, pilotait ses prix sous Excel, avec un seul taux de marge pour tout le magasin.
Son directeur pricing pilote quatre enseignes, face à un concurrent doté d'une équipe pricing d'environ dix personnes. Le groupe est passé directement d'Excel à une IA hybride, règles métier et modèles, sans étape intermédiaire.
Chaque rôle de catégorie (trafic, chiffre d'affaires, marge) reçoit trois prix optimaux. Résultat : +1 point de taux de marge sur les produits testés en un trimestre, avant l'extension aux quatre enseignes.
Source : webinar public Booper × Groupe Barbotteau, Pricing Club, 2026.
La réponse à cet écart de moyens n'a été ni une équipe data interne, ni un LLM chargé des prix. C'est un outil qui embarque la méthode, piloté par l'expert métier.
Le moteur d'optimisation de BOOPER MPS combine GENIUS Price pour les règles, filtres et simulations métier, GENIUS Link pour le matching concurrentiel par NLP, et GENIUS Predict pour la prévision de ventes et l'élasticité, le tout connecté aux données de l'enseigne via Data Loader.
Chaque recommandation reste explicable et validable par une équipe pricing, jamais déployée en boîte noire à partir d'un modèle isolé.
Libre ensuite à cette équipe d'utiliser l'IA généraliste de son choix pour explorer les résultats ou en rédiger la synthèse.
IA généraliste et solution dédiée : 30 minutes avec nos équipes pour définir la bonne répartition des rôles sur votre catalogue.
Planifions un échangeÀ chacun son rôle
Réunies dans un tableau, ces briques montrent moins un vainqueur qu'une répartition des rôles.
| Dimension | LLM généraliste | Solution de pricing spécialisée |
|---|---|---|
| Donnée prix réelle | À connecter et maintenir soi-même, hors du modèle. | Native, connectée dès le déploiement. |
| Règles et contexte métier | Redits à chaque requête, respect non garanti. | Inscrits une fois, versionnés, contrôlés. |
| Simulation d'impact | Absente par défaut. | Faite avant tout changement de prix. |
| Explicabilité et audit | Raisonnement plausible, rarement traçable. | Recommandation justifiée et historisée. |
| Rôle le plus utile | Explorer, rédiger, synthétiser. | Chiffrer, simuler et justifier le prix final. |
En pratique, la frontière se trace avant tout comparatif technique. Tout ce qui fixe, simule ou justifie un prix relève de la solution spécialisée ; tout ce qui explore, résume ou rédige peut rester au LLM.
Le piège le plus fréquent est la dérive : un usage d'exploration qui glisse, par commodité, vers la décision. C'est la gouvernance qui l'empêche, pas l'outil.
Le choix n'est donc pas entre IA généraliste et solution spécialisée : il est dans la répartition des rôles. Pour la poser sur votre catalogue, échangez avec nos équipes.
Pour aller plus loin : la question voisine : développer son propre moteur avec une équipe data interne.
À lire aussi dans ce dossier
- IA et pricing : ce qui relève vraiment de l'intelligence artificielle
- IA qui décide vs IA qui exécute : où mettre le curseur en pricing
- Comment fonctionne un moteur de pricing IA ? Données et garde-fous
- Recommandations de prix IA : explicables et auditables pour le retail
FAQ
Non. Le LLM généraliste est utile pour explorer une hypothèse, rédiger une note ou résumer une simulation. La décision de prix, elle, demande la donnée connectée, les règles métier, la simulation et la trace qu'apporte une solution spécialisée.
Un LLM génère un texte plausible depuis sa mémoire d'entraînement, sans connexion garantie à une donnée à jour ni à des règles explicites.
Une solution de pricing modélise la demande, applique des règles versionnées et simule l'impact avant tout changement. L'un formule, l'autre chiffre.
Il peut proposer un prix, mais sans garantie qu'il repose sur vos coûts, vos prix concurrents du jour ou vos règles. Il ne mesure pas l'effet sur les ventes et la marge, et il oublie le contexte d'une session à l'autre.
Il reste utile pour préparer ou expliquer une décision, pas pour la prendre.
En réservant le LLM à l'exploration, à la rédaction et à la synthèse, et en laissant à la solution spécialisée tout ce qui fixe, simule ou justifie un prix. Le LLM peut ainsi s'appuyer sur des résultats chiffrés et gouvernés, au lieu de les inventer.
Selon l'étude MIT NANDA de 2025, 95 % des organisations étudiées n'en tirent aucun retour mesurable. La cause tient moins au modèle qu'à des outils qui n'apprennent pas, ne retiennent pas le contexte et s'intègrent mal aux flux de travail.
Oui, par une intégration sur mesure. Mais cette connexion ne fait pas partie du modèle : elle doit être construite, sécurisée et maintenue à part, comme les règles métier et la simulation. Une solution spécialisée réunit ces briques nativement.
Sources
MIT NANDA, The GenAI Divide: State of AI in Business 2025 (juillet 2025) · Gartner, juillet 2024 · Simon-Kucher, Global Pricing Study 2025 · webinar public Booper × Groupe Barbotteau, Pricing Club, 2026. Dernière mise à jour : 26 octobre 2026.

Choisir un logiciel de prévision des ventes, c'est vérifier cinq points avant tout test : la demande cachée par les ruptures, la maille, l'explication de chaque chiffre, le lien avec les prix et les promotions, et une mesure honnête de la précision.
Une démonstration ne prouve rien sur ces points. Seul un test sur vos propres données, comparé à une référence simple, montre si la prévision améliore vraiment vos décisions.

Un POC de pricing n'exige pas des données parfaites, mais des données adaptées à ce qu'il doit démontrer, dont les limites sont connues. Référentiel produit, ventes, prix et promotions, coûts d'achat et stocks forment le socle ; leur maille et leur profondeur dépendent de l'objectif du test.
Avant de mesurer un gain, le chiffre d'affaires, les volumes et la marge recalculés doivent retomber sur ceux du contrôle de gestion. Un défaut connu et documenté ne fausse pas la comparaison ; un défaut caché, si.
Le modèle est la partie facile d'un outil de pricing. Ce qui prend des années, c'est le référentiel produit, le matching produit avec les concurrents, les règles, l'explicabilité et la conformité, dont certaines règles ont des dates d'échéance. Tous outils confondus, 71 % des développements internes finissent abandonnés selon Exclaimer (2025).
Le coût caché est celui de la continuité : un outil interne repose sur deux ou trois personnes, et c'est son succès qui crée la dépendance. Le build garde du sens sur un périmètre étroit et stable, en complément d'une plateforme. Le critère de choix n'est pas la capacité à construire, c'est la capacité à entretenir dix ans.