
Scraping, relevés terrain, panélistes : quelles différences ?

Fabrice Decroo
Directeur du Consulting
August 16, 2026
Le relevé terrain, le web scraping et les panels distributeurs répondent chacun à une question différente : ce que voit le client en rayon, ce qui est affiché en ligne à l'instant T, et ce qui a réellement été vendu. Les confondre revient à répondre à la mauvaise question avec la bonne donnée.
Chez les grands retailers multicanaux, la part des prix qui changent chaque mois est passée de 15% à près de 30% entre 2008 et 2017 — un rythme qu'un relevé hebdomadaire ou un panel mensuel ne peut structurellement pas suivre (Alberto Cavallo, NBER).
« On surveille déjà nos concurrents » ne veut rien dire tant qu'on n'a pas répondu à une question précise : quelle donnée, collectée comment, avec quelle fraîcheur ? Trois pratiques très différentes se cachent derrière cette phrase — le relevé terrain, le web scraping, les panels de distributeurs — et elles répondent chacune à une question différente, avec un coût, une fraîcheur et une fiabilité qui n'ont rien à voir. Les confondre, ce n'est pas une nuance méthodologique : c'est prendre une décision de prix sur la mauvaise source de données. Ce guide compare les trois méthodes point par point, et donne les critères pour bâtir une architecture qui les combine plutôt que d'en choisir une seule par défaut.
Pourquoi ces trois méthodes sont systématiquement confondues
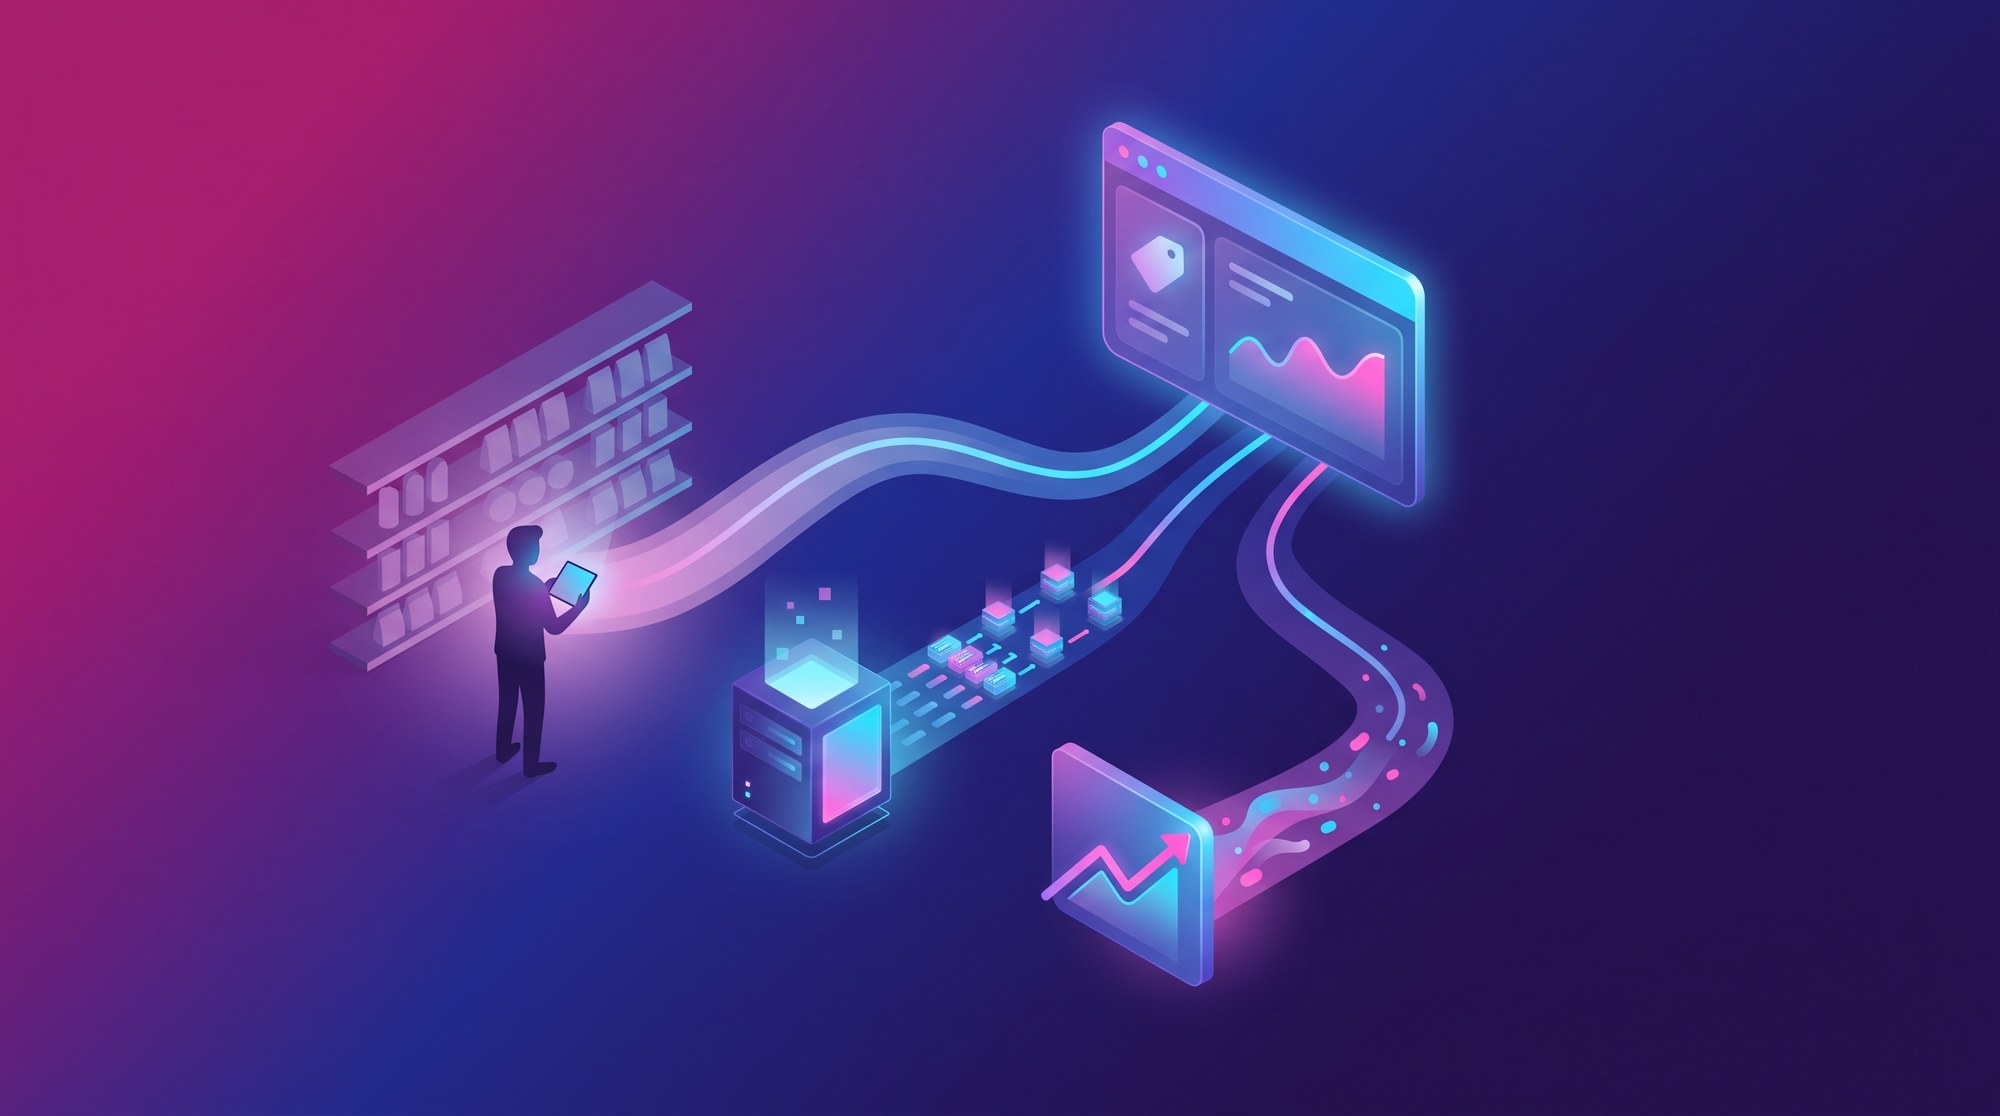
Dans la plupart des organisations retail, « faire de la veille prix » recouvre trois réalités distinctes. Le relevé terrain : un humain observe et note un prix, physiquement ou par consultation manuelle. Le web scraping : un robot interroge automatiquement des pages web et structure les prix affichés en données exploitables — notre article de définition détaille précisément ce mécanisme. Les panels distributeurs : un tiers agrège des données de caisse ou de panélistes, avec un décalage temporel assumé, pour mesurer la demande réelle.
Traiter ces trois sources comme interchangeables coûte cher, très concrètement. Une équipe qui pilote ses ajustements hebdomadaires sur une extraction de panel reçue avec plusieurs semaines de retard réagit toujours après le marché. À l'inverse, une équipe qui fonde un repositionnement stratégique sur trois jours de scraping prend un bruit statistique pour une tendance de fond, faute de la profondeur d'historique qu'apporte un panel.
Relevé terrain
Un humain se déplace ou consulte, note ce qu'il voit : prix affiché, mais aussi merchandising et rupture réelle.
Web scraping
Un robot interroge automatiquement les pages produit et structure les prix affichés en données exploitables.
Panels distributeurs
Un tiers agrège des données de caisse ou de panélistes, avec un décalage, pour mesurer ce qui a réellement été vendu.
Choisir selon la question posée
Chaque méthode répond à une question différente. Les confondre, c'est répondre à la mauvaise question avec la bonne donnée.
Les trois sections suivantes détaillent, l'une après l'autre, ce que chaque méthode capture réellement — et surtout ce qu'elle ne capture pas.
Le relevé terrain : ce qu'il capture, ce qu'il ne capture pas
Le relevé terrain consiste à observer et enregistrer, physiquement ou par consultation manuelle, le prix affiché d'un produit chez une enseigne — un category manager qui parcourt un rayon concurrent, un enquêteur mandaté qui visite un point de vente, un collaborateur qui note à la main les prix affichés en ligne.
C'est la seule des trois méthodes qui capture ce qui se passe réellement en rayon : la disponibilité produit face au client — pas la disponibilité déclarée en ligne —, l'exécution du merchandising, la cohérence entre le prix annoncé en tête de gondole et le prix réellement scanné en caisse, la perception visuelle qu'a un acheteur au moment de sa décision. Aucun scraping, aussi sophistiqué soit-il, ne voit un linéaire vide ou une promotion mal signalée, parce qu'un site web peut afficher un produit « disponible » alors qu'il est en rupture physique depuis deux jours.
c'est le taux de rupture moyen en rayon observé sur un échantillon mondial de plus de 71 000 consommateurs dans 29 pays — un chiffre qu'aucune donnée en ligne ne peut révéler (Corsten & Gruen, Harvard Business Review, 2004).
Sa limite est structurelle, pas technique : elle ne passe pas à l'échelle. Un relevé terrain sur 200 références chez 5 enseignes mobilise un temps humain incompressible ; le multiplier par 10 catégories et 20 enseignes revient à financer une équipe dédiée à plein temps, avec un coût qui croît linéairement quand celui du scraping croît à peine. C'est pour cette raison que le terrain reste, dans la plupart des dispositifs matures, un complément ciblé — un audit ponctuel, un contrôle qualité sur échantillon — plutôt que le socle du pilotage tarifaire quotidien.
Le web scraping : fraîcheur et granularité, mais des angles morts précis
Le web scraping — dont le fonctionnement technique en trois couches (collecte, matching, restitution) est détaillé dans notre article de définition — est un processus automatisé qui interroge des pages web publiques à intervalles programmés et structure les prix affichés en données exploitables. Sa force est double : la fraîcheur, avec une collecte quotidienne voire pluriquotidienne possible, et la granularité produit par produit, sans limite d'échelle liée au temps humain.
Cette fraîcheur n'est pas un confort, c'est une nécessité dictée par le marché lui-même.
c'est la proportion de prix qui changent chaque mois chez les grands retailers multicanaux, passée de 15 % en 2008-2010 à près de 30 % en 2014-2017 — un rythme qu'un relevé hebdomadaire ou un panel mensuel ne peut structurellement pas suivre (Alberto Cavallo, NBER, Working Paper 25138, 2018).
Le scraping a des angles morts précis, symétriques à ceux du terrain. Il ne voit que ce qu'un site web publie — jamais le magasin physique, ni le prix réellement payé en caisse après une remise non affichée en ligne, ni la disponibilité réelle en rayon. Il dépend aussi entièrement de la structure du site ciblé : un changement de template, une protection anti-bot renforcée ou une page qui bascule en rendu dynamique côté client peuvent interrompre la collecte sans que personne ne s'en aperçoive, si le taux de couverture n'est pas surveillé en continu.
Les panels distributeurs : la vérité retardée
Les panels de distributeurs — NielsenIQ, Kantar Worldpanel, et leurs équivalents sectoriels — ne mesurent pas le prix affiché : ils mesurent le prix réellement payé, agrégé à partir de données de caisse ou de tickets déclarés par un échantillon de foyers. C'est une différence de nature avec le scraping, pas de degré. Un panel dit ce qui s'est vendu, à quel prix, à quel volume. Un scraping dit ce qui est affiché, à un instant donné, sans certitude sur ce qui a été réellement acheté à ce prix.
Le prix de cette fiabilité est un décalage temporel structurel. Les données d'un panel sont collectées, agrégées, dédupliquées et validées avant restitution — un processus qui prend, selon les fournisseurs et les marchés, plusieurs semaines.
magasins dans le monde, pour 50 millions de produits suivis chaque mois : l'échelle des panels de distribution donne une lecture massive et fiable de la demande réelle, au prix d'une cadence mensuelle incompatible avec un pilotage tarifaire réactif (NielsenIQ, Retail Measurement Services).
Ce décalage rend un panel inutilisable pour un ajustement tarifaire réactif — mais c'est précisément ce qui le rend irremplaçable pour valider une tendance de fond. Un scraping peut signaler qu'un concurrent affiche un prix 5 % plus bas depuis trois jours ; seul un panel peut confirmer, plusieurs semaines plus tard, si cet écart affiché s'est traduit par un transfert de volume réel, ou s'il est resté un artefact d'affichage sans impact mesurable sur la demande.
Le comparatif détaillé des trois méthodes
| Méthode | Fraîcheur | Granularité produit | Coût | Ce qui est réellement mesuré |
|---|---|---|---|---|
| Relevé terrain | Ponctuelle | Échantillon limité | Élevé | Perception, merchandising, disponibilité réelle en rayon |
| Web scraping | Temps réel | Très fine, produit par produit | Modéré | Prix affiché en ligne, à l'instant T |
| Panels distributeurs | Plusieurs semaines | Agrégée par catégorie / référence | Élevé | Prix réellement payé, volume vendu |
À lire ainsi : la colonne « ce qui est réellement mesuré » est la plus importante des quatre. Un prix affiché scrapé, un prix payé mesuré par un panel et une perception observée sur le terrain ne sont pas trois versions plus ou moins précises de la même information — ce sont trois informations différentes, qui répondent à trois questions différentes. Confondre les colonnes, c'est répondre à la mauvaise question avec la bonne donnée.
Comment les combiner en architecture hybride selon votre maturité
La question n'est jamais « scraping, terrain ou panel », mais dans quel ordre et pour quel usage les combiner. La maturité d'un dispositif de veille tarifaire se construit par paliers, pas par un choix binaire fait une fois pour toutes.
Terrain ponctuel + tableur
Premiers relevés manuels compilés à la main, souvent dans un tableur. Fonctionne sur un petit périmètre, ne tient pas la charge au-delà.
Scraping mono-source pour le pilotage quotidien
Un scraping automatisé prend le relais sur les catégories les plus volatiles, avec un matching produit encore rudimentaire.
Scraping multi-source + terrain ciblé en contrôle qualité
Le matching se fiabilise, la couverture s'élargit, et un relevé terrain ponctuel vient auditer ce que le scraping ne peut pas voir.
Architecture gouvernée, arbitrée par catégorie
Scraping, terrain et panel coexistent, chacun affecté à la décision qu'il éclaire le mieux, avec une gouvernance qui arbitre les écarts.
À chaque palier, la question qui doit guider l'arbitrage n'est pas « quelle méthode est la meilleure » dans l'absolu, mais quelles références et quelles catégories justifient l'investissement — une priorisation détaillée dans notre article sur les produits à réellement surveiller. Beaucoup d'organisations restent bloquées au premier palier, avec un dispositif construit à la main dans un tableur, pour des raisons documentées dans notre article sur les limites d'Excel pour la surveillance des prix.
Chez Booper
C'est exactement la trajectoire suivie par Barbotteau Group, leader du retail dans la Caraïbe française avec plus de 70 entreprises et enseignes : un pilotage historiquement construit sur Excel, puis une logique à règles, puis une IA hybride, avant l'automatisation complète — chaque palier adapté à la réalité de l'organisation. En aval de cette collecte, quelle qu'en soit la source, le module GENIUS Link rapproche automatiquement les références par NLP, avec un score de confiance par produit, et GENIUS Monitoring centralise les alertes pour que chaque source alimente une décision plutôt qu'un tableau supplémentaire.
La bonne question n'est pas « laquelle choisir »
Aucune des trois méthodes n'est universellement supérieure aux deux autres — chacune répond à une question que les deux autres ne peuvent pas poser à sa place. Le terrain répond à « que voit et vit le client en rayon ? ». Le scraping répond à « à quel prix mon concurrent affiche-t-il ce produit, maintenant ? ». Le panel répond à « qu'est-ce qui s'est réellement vendu, et à quel prix ? ». Découvrez comment Booper structure cette architecture complète sur notre page relevés de prix & webscraping.
La checklist avant de juger votre architecture de veille prix
- Savez-vous quelle décision chaque source de donnée est censée éclairer, ou les utilisez-vous indifféremment ?
- Votre scraping capture-t-il la fraîcheur nécessaire à vos catégories les plus volatiles ?
- Un relevé terrain, même ponctuel, vient-il contrôler ce que le scraping ne peut pas voir (rupture réelle, merchandising) ?
- Vos données de panel servent-elles à valider une tendance, ou à piloter au jour le jour — une confusion fréquente ?
- Votre dispositif combine-t-il ces sources, ou n'en utilise-t-il qu'une par défaut, faute d'architecture pensée ?
FAQ
Les questions qu'on nous pose le plus souvent avant de se lancer.
Le relevé terrain consiste à observer et enregistrer, physiquement ou par consultation manuelle, le prix affiché d’un produit chez une enseigne — un category manager qui parcourt un rayon concurrent, un enquêteur qui visite un point de vente. C’est la seule des méthodes qui capture ce qui se passe réellement en rayon : la disponibilité produit face au client, l’exécution du merchandising, la cohérence entre le prix annoncé en tête de gondole et le prix scanné en caisse.
Le web scraping, à l’inverse, est un processus automatisé qui interroge des pages web publiques à intervalles programmés et structure les prix affichés en données exploitables — sans limite d’échelle liée au temps humain, avec une fraîcheur pouvant aller jusqu’au temps réel.
Sa contrepartie est un angle mort symétrique à celui du terrain : le scraping ne voit jamais un linéaire vide, une promotion mal signalée, ou une disponibilité en ligne qui ne reflète pas la réalité physique du magasin. Un site peut afficher un produit « disponible » alors qu’il est en rupture depuis deux jours.
C’est pour cette raison que le terrain reste, dans les dispositifs matures, un complément ciblé — audit ponctuel, contrôle qualité sur échantillon — plutôt que le socle du pilotage quotidien, faute de pouvoir passer à l’échelle : un relevé sur 200 références chez 5 enseignes mobilise déjà un temps humain incompressible.
Non. Un panel distributeur ne mesure pas le prix affiché, mais le prix réellement payé, agrégé à partir de données de caisse ou de tickets déclarés par un échantillon de foyers — une différence de nature avec le scraping, pas de degré.
Le prix de cette fiabilité est un décalage temporel structurel : les données sont collectées, agrégées, dédupliquées et validées avant restitution, un processus qui prend, selon les fournisseurs et les marchés, plusieurs semaines. NielsenIQ, par exemple, mesure environ 900 000 magasins dans le monde pour 50 millions de produits suivis chaque mois — une échelle massive, mais à une cadence mensuelle incompatible avec un pilotage tarifaire réactif.
Ce décalage rend un panel inutilisable pour un ajustement tarifaire au jour le jour, mais c’est précisément ce qui le rend irremplaçable pour valider une tendance de fond : un scraping peut signaler qu’un concurrent affiche un prix 5 % plus bas depuis trois jours, seul un panel confirmera, plusieurs semaines plus tard, si cet écart s’est traduit par un transfert de volume réel.
Un dispositif de veille tarifaire complet a donc besoin des deux logiques : le scraping pour la réactivité quotidienne, le panel pour la validation de fond.
Non, il capture le prix affiché à un instant donné — pas nécessairement le prix effectivement payé. Une remise appliquée uniquement en caisse, un prix négocié, ou un avantage de programme de fidélité non reflété en ligne ne sont pas visibles par un scraping.
C’est précisément le rôle des panels distributeurs : ils mesurent le prix réellement payé et le volume vendu, agrégés à partir de données de caisse ou de panels de consommateurs, là où le scraping ne voit que ce qu’un site web publie.
Le scraping a aussi des angles morts qui dépendent de la structure technique du site ciblé : un changement de template, une protection anti-bot renforcée, ou une page qui bascule en rendu dynamique côté client peuvent interrompre la collecte sans que personne ne s’en aperçoive si le taux de couverture n’est pas surveillé en continu.
C’est pourquoi le prix affiché scrapé, le prix payé mesuré par un panel et l’observation terrain ne sont pas trois versions plus ou moins précises de la même information : ce sont trois informations différentes, qui répondent à trois questions différentes.
Les combiner. Le scraping alimente le pilotage tarifaire quotidien grâce à sa fraîcheur, le terrain contrôle ponctuellement ce que le scraping ne peut pas voir (rupture réelle, merchandising), le panel valide que les écarts observés se traduisent effectivement en volume réel.
Le bon dosage se construit par paliers de maturité plutôt que par un choix binaire fait une fois pour toutes : un terrain ponctuel compilé dans un tableur, puis un scraping mono-source sur les catégories les plus volatiles, puis un scraping multi-source avec du terrain en contrôle qualité, jusqu’à une architecture gouvernée où les trois sources coexistent, chacune affectée à la décision qu’elle éclaire le mieux.
La question qui doit guider l’arbitrage n’est jamais « quelle méthode est la meilleure » dans l’absolu, mais quelles références et quelles catégories justifient l’investissement dans chacune.
C’est exactement la trajectoire suivie par Barbotteau Group, leader du retail dans la Caraïbe française avec plus de 70 entreprises et enseignes : un pilotage historiquement construit sur Excel, puis une logique à règles, puis une IA hybride, avant l’automatisation complète — chaque palier adapté à la réalité de l’organisation.
Parce que leurs données proviennent de la collecte, l’agrégation, la déduplication et la validation de remontées de caisse ou de panels de consommateurs à grande échelle — un processus qui, pour rester fiable statistiquement, ne peut pas être instantané.
À la différence du web scraping, qui structure une donnée collectée en direct sur une page web, un panel doit rassembler des milliers, voire des millions de points de vente ou de foyers avant de pouvoir produire un chiffre représentatif. NielsenIQ, par exemple, mesure environ 900 000 magasins dans le monde pour 50 millions de produits suivis chaque mois — une échelle qui explique la cadence mensuelle plutôt que quotidienne.
Ce délai n’est pas un défaut à corriger, c’est la contrepartie de la fiabilité recherchée : un panel dit ce qui s’est vendu, à quel prix, à quel volume, avec une rigueur statistique qu’une collecte instantanée ne pourrait pas garantir.
C’est ce qui rend un panel adapté à la validation de tendances de fond, et structurellement inadapté à un pilotage tarifaire réactif au jour le jour, un rôle que remplit plutôt le scraping.
Oui, sur un périmètre ciblé. Le scraping ne voit jamais un linéaire vide, une promotion mal signalée, ou l’expérience réelle du client en rayon — des éléments que seul un relevé terrain, même occasionnel, peut objectiver.
Le taux de rupture moyen en rayon observé sur un large échantillon international est de 8,3 % selon une étude Harvard Business Review — un chiffre qu’aucune donnée en ligne ne peut révéler, puisqu’un site peut afficher un produit disponible alors qu’il est en rupture physique depuis plusieurs jours.
Le terrain garde donc sa place, non plus comme socle du pilotage quotidien — sa limite de passage à l’échelle reste structurelle —, mais comme complément ciblé : un audit ponctuel, un contrôle qualité sur échantillon, qui vient vérifier ce que le scraping ne peut structurellement pas capter.
Dans une architecture de veille tarifaire mature, ces trois sources (terrain, scraping, panel) coexistent, chacune affectée à la décision qu’elle éclaire le mieux plutôt que traitées comme interchangeables.
À lire aussi dans ce dossier
- Qu'est-ce que le relevé de prix ou le web scraping dans le retail ?
- Prix concurrents : quels produits faut-il réellement surveiller ?
- Les limites d'Excel pour surveiller les prix concurrents
Sources : NBER, Alberto Cavallo, More Amazon Effects: Online Competition and Pricing Behaviors, Working Paper 25138, 2018 · Corsten & Gruen, Stock-Outs Cause Walkouts, Harvard Business Review, mai 2004 · NielsenIQ, Retail Measurement Services.
Sept critères séparent un outil de relevé de prix concurrents qui produit un tableau d'écarts de plus d'un outil qui pilote réellement des décisions : couverture, fraîcheur, matching produit, alertes, gouvernance, intégration et conformité. Le coût affiché n'est qu'une partie du coût total : requalification manuelle, maintenance d'un développement interne et coût d'opportunité d'une décision mal informée pèsent souvent plus lourd que l'abonnement.
Une veille tarifaire concurrents complète repose sur 5 briques indissociables : collecte, matching, alertes, restitution et gouvernance, une seule brique manquante suffit à la rendre inopérante. Le retail est le secteur qui révise ses prix le plus souvent (mensuel à quotidien selon les catégories), ce qui impose un dispositif capable de suivre cette cadence.
Beaucoup d'organisations reçoivent chaque matin un tableau d'écarts de prix concurrents, mais peu ont une véritable stratégie. La différence tient à trois questions posées avant de lancer le dispositif : pourquoi collecter cette donnée, sur quoi précisément, et pour décider quoi une fois l'écart constaté.
Point de repère : les key value items (KVI) (les références dont les clients retiennent le prix) représentent généralement 15 à 25 % des ventes d'une catégorie. Concentrer l'effort de surveillance sur ce noyau restreint est plus rentable que de vouloir tout suivre avec la même intensité.